NVIDIA B200 и B300: сравнение характеристик и сценариев применения
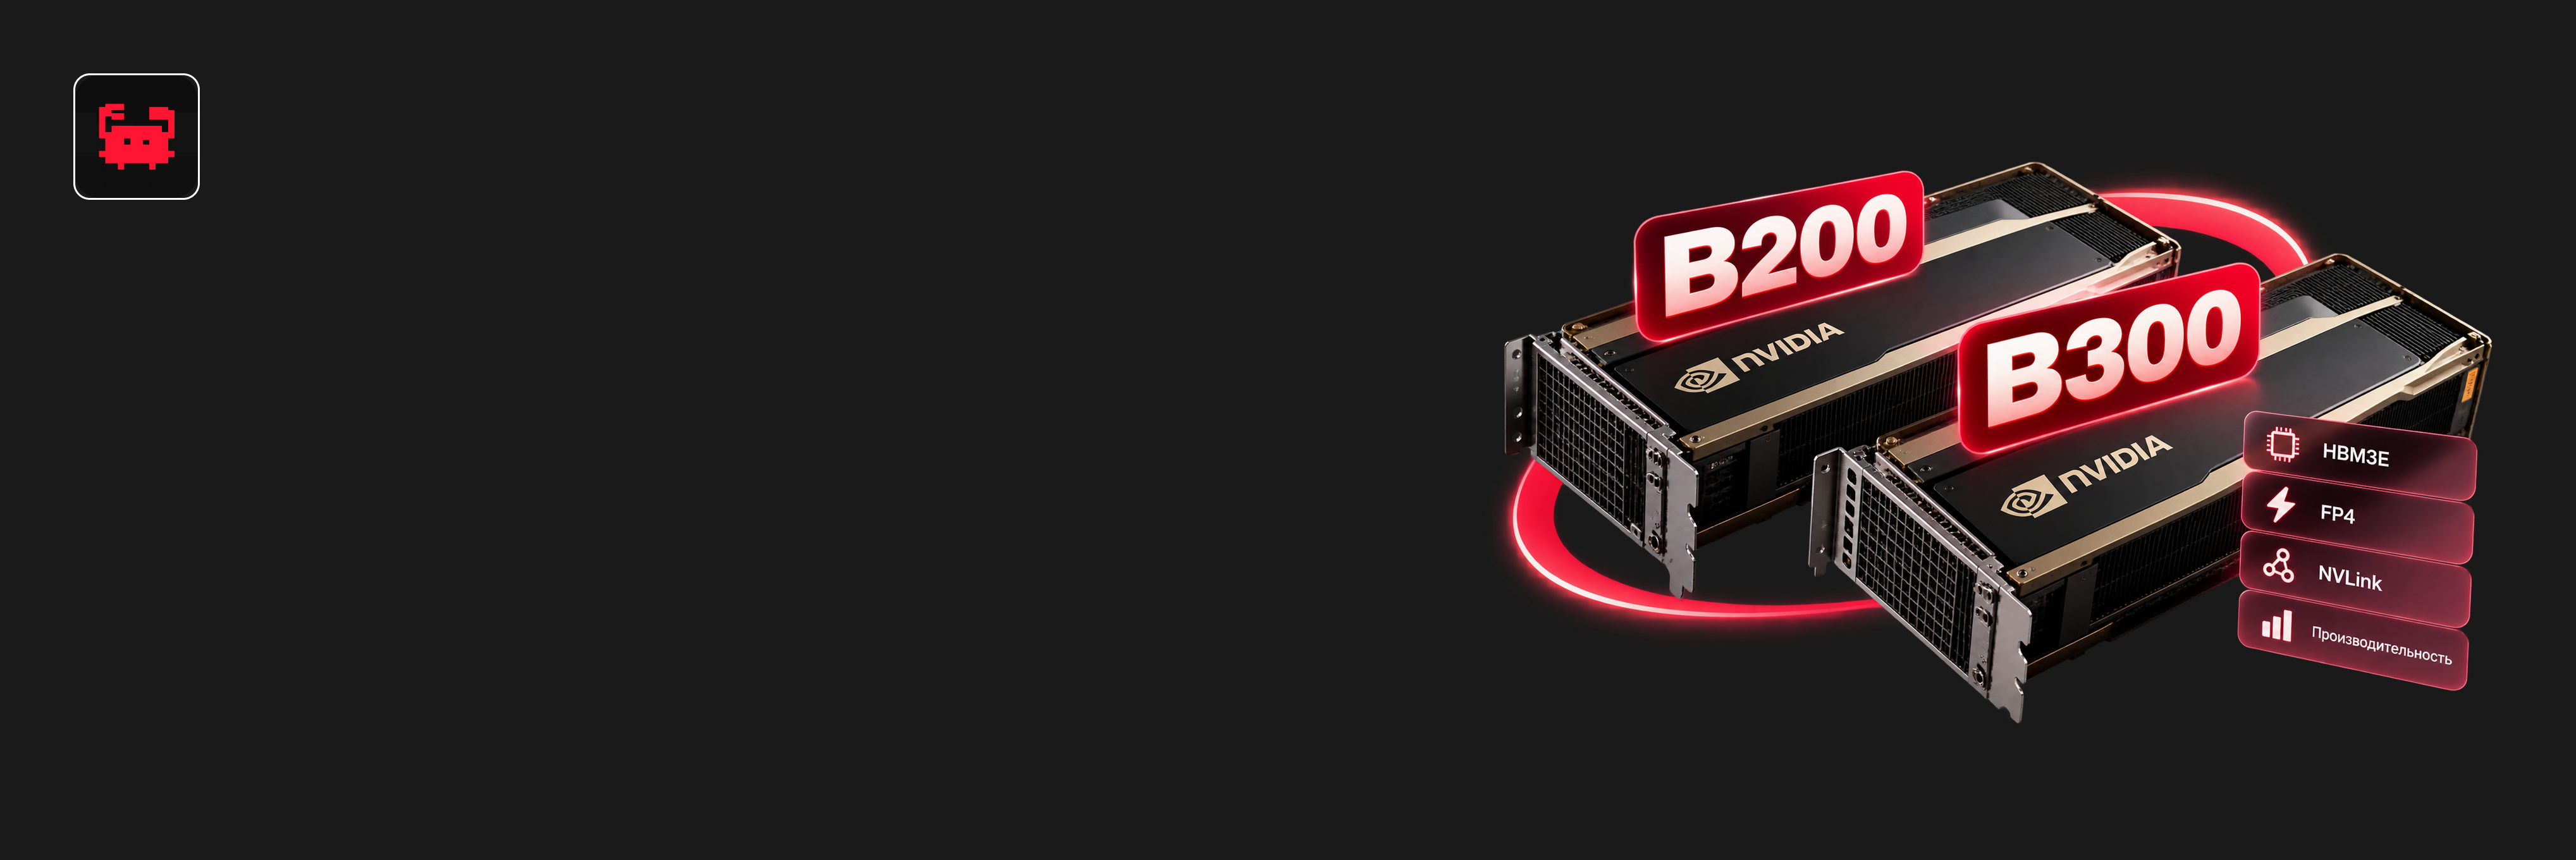
NVIDIA B200 и B300 относятся к разным этапам развития архитектуры Blackwell и заметно различаются по памяти, вычислительным возможностям и требованиям к серверной платформе. В статье разберем, как эти отличия проявляются в реальных ИИ-нагрузках, для каких задач имеет смысл рассматривать B300 и в каких сценариях возможностей B200 будет достаточно.
В этой статье:
- B200 и B300 в линейке NVIDIA: что означают названия
- NVIDIA B200 и B300: сравнение характеристик
- Как характеристики B200 и B300 влияют на ИИ-нагрузки
- B200 и B300 в сервере: конкретные сценарии и конфигурации
- В каких случаях B300 не дает практического преимущества
- Вопросы и ответы
B200 и B300 в линейке NVIDIA: что означают названия
В описаниях ИИ-серверов рядом с B200 и B300 часто встречаются HGX B200, DGX B200, GB200, HGX B300, DGX B300 и GB300. Похожие обозначения могут создавать впечатление, что речь идет о разных версиях одного ускорителя. На самом деле они обозначают разные уровни системы: отдельный ускоритель, серверную платформу, готовый сервер или связку центрального процессора с ускорителями.
B200 и B300
NVIDIA B200 — ускоритель поколения Blackwell для центров обработки данных.
NVIDIA B300 — ускоритель Blackwell Ultra. NVIDIA использует название Blackwell Ultra для дальнейшего развития платформы Blackwell.
То есть B200 и B300 — два самостоятельных ускорителя. Именно их характеристики будем сравнивать дальше.
HGX B200 и HGX B300
HGX — серверная вычислительная платформа NVIDIA. Производители оборудования используют ее как основу для собственных серверов.
HGX B200 построена на восьми ускорителях B200, HGX B300 — на восьми B300. Остальные компоненты и конструкция сервера зависят от конкретной модели производителя.
Поэтому HGX B200 или HGX B300 — это уже не название отдельного ускорителя. Так обозначают платформу на базе нескольких ускорителей.
DGX B200 и DGX B300
DGX — готовые вычислительные системы NVIDIA.
DGX B200 включает восемь ускорителей B200, а DGX B300 — восемь B300. В отличие от HGX, здесь речь идет уже о готовой системе с процессорами, оперативной памятью, накопителями, сетевыми компонентами, питанием и охлаждением.
Разница между обозначениями получается простой: HGX служит основой для серверов разных производителей, DGX обозначает готовую систему NVIDIA.
Чем GB200 и GB300 отличаются от B200 и B300
В названиях GB200 и GB300 буква G связана с процессорами NVIDIA Grace.
GB200 относится к семейству Grace Blackwell, а GB300 — к Grace Blackwell Ultra. В таких решениях центральный процессор Grace работает вместе с двумя ускорителями соответствующего поколения в составе одного вычислительного модуля.
Поэтому B300 и GB300 нельзя использовать как взаимозаменяемые названия. B300 обозначает отдельный ускоритель, а GB300 — решение Grace Blackwell Ultra, в котором центральный процессор и ускорители работают как единая вычислительная система.
| Обозначение | Что это |
| B200 | ускоритель NVIDIA поколения Blackwell |
| B300 | ускоритель NVIDIA Blackwell Ultra |
| HGX B200 / HGX B300 | серверная платформа NVIDIA на базе восьми ускорителей |
| DGX B200 / DGX B300 | готовая вычислительная система NVIDIA на базе восьми ускорителей |
| GB200 / GB300 | решения Grace Blackwell, объединяющие процессор Grace и ускорители Blackwell соответствующего поколения |
NVIDIA B200 и B300: сравнение характеристик
B200 и B300 различаются прежде всего объемом памяти и вычислительной производительностью в FP4. При этом часть параметров, включая скорость NVLink, осталась на прежнем уровне. Для сравнения вычислительной производительности ниже приведены показатели платформ HGX с восемью ускорителями. Так мы сравниваем B200 и B300 в одинаковых условиях.
| Характеристика | NVIDIA B200 | NVIDIA B300 |
| Архитектура | Blackwell | Blackwell Ultra |
| Память | 180 ГБ HBM3e | 270–288 ГБ HBM3e в зависимости от исполнения |
| Пропускная способность памяти | до 8 ТБ/с | до 8 ТБ/с в зависимости от исполнения |
| FP4 без структурной разреженности, HGX с 8 ускорителями | 72 петафлопс | 108 петафлопс |
| FP8/FP6 без структурной разреженности, HGX с 8 ускорителями | 36 петафлопс | 36 петафлопс |
| NVLink | пятое поколение, до 1,8 ТБ/с на ускоритель | пятое поколение, до 1,8 ТБ/с на ускоритель |
| Настраиваемая мощность ускорителя в HGX | до 1000 Вт | до 1100 Вт |
Память
B200 и B300 используют HBM3e. Это память с высокой пропускной способностью, которую размещают непосредственно рядом с вычислительными кристаллами ускорителя.
B200 оснащается 180 ГБ HBM3e. Для B300 объем зависит от конкретного исполнения. В официальных спецификациях NVIDIA встречаются варианты с 270 и 288 ГБ.
Пропускная способность памяти при этом выросла не пропорционально емкости. У B200 она достигает 8 ТБ/с. Для разных исполнений B300 NVIDIA также указывает значения до 8 ТБ/с. Поэтому одно из главных изменений Blackwell Ultra связано именно с увеличением доступного объема памяти.
Если нужно посмотреть, как объем памяти менялся между предыдущими поколениями ускорителей NVIDIA, это отдельно разбирали в статье NVIDIA A100, H100 или H200: какую GPU выбрать для ИИ.
Вычислительная производительность
NVIDIA указывает производительность B200 и B300 для нескольких форматов вычислений. В задачах искусственного интеллекта среди них применяются FP4, FP8 и FP6. Чем меньше разрядность представления данных, тем меньше данных требуется хранить и передавать при вычислениях. Использовать конкретный формат можно только в тех моделях и программных средствах, которые его поддерживают.

Наиболее заметная разница между HGX B200 и HGX B300 видна в FP4 без структурной разреженности. Для платформы с восемью ускорителями показатель составляет 72 петафлопс у B200 и 108 петафлопс у B300.
По FP8 и FP6 сопоставимый показатель без разреженности у обеих платформ одинаковый: 36 петафлопс. Поэтому переход с B200 на B300 увеличивает производительность не во всех форматах вычислений.
В спецификациях NVIDIA можно увидеть и более высокие значения с пометкой о структурной разреженности. В таком режиме часть значений в вычисляемых матрицах равна нулю, а оборудование может пропускать связанные с ними операции. За счет этого пиковый показатель получается выше. Такой режим требует подходящей структуры данных и программной поддержки, поэтому значения с разреженностью нельзя считать универсальной производительностью для любой модели.
Связь между ускорителями
B200 и B300 используют NVLink пятого поколения. Эта технология обеспечивает прямой обмен данными между ускорителями внутри вычислительного узла.
Для обоих поколений пропускная способность составляет до 1,8 ТБ/с на ускоритель. В платформе HGX с восемью ускорителями совокупный показатель достигает 14,4 ТБ/с.
Поэтому более высокая производительность B300 не связана с переходом на новое поколение NVLink: по этому параметру B200 и B300 находятся на одном уровне.
Энергопотребление
Для B200 в составе HGX NVIDIA указывает настраиваемую мощность до 1000 Вт на ускоритель. Для B300 в HGX верхняя граница достигает 1100 Вт.
Речь идет о максимальной расчетной мощности конкретного исполнения. Она нужна производителю серверной системы при проектировании питания и отвода тепла. Фактическое потребление зависит от нагрузки и настроек.
Из этих значений нельзя делать вывод, что сервер с B300 обязательно требует жидкостного охлаждения. Способ охлаждения зависит от конструкции конкретной серверной платформы.
По характеристикам B300 прежде всего отличается от B200 большим объемом HBM3e и более высокой производительностью FP4 без структурной разреженности. Скорость NVLink осталась прежней, а максимальная мощность ускорителя в HGX выросла. В следующей главе разберем, какое значение эти различия имеют для конкретных ИИ-нагрузок.
Как характеристики B200 и B300 влияют на ИИ-нагрузки
Разница между B200 и B300 важна в тех случаях, когда нагрузка упирается в память или вычислительные возможности ускорителя. Само название модели и число ее параметров еще не показывают, какой вариант подойдет. На требования влияют способ представления данных, длина контекста, число одновременно обрабатываемых запросов и режим работы модели.
Когда ограничением становится память
Во время работы большой языковой модели память ускорителя занимает несколько типов данных. Значительную часть составляют веса модели. Дополнительный объем нужен для промежуточных результатов вычислений и данных, которые система сохраняет во время обработки запроса.
Поэтому нельзя провести универсальную границу по числу параметров и сказать, что модели до определенного размера рассчитаны на B200, а более крупные требуют B300. Одна и та же модель может занимать разный объем памяти в зависимости от точности представления данных и способа распределения вычислений между ускорителями.
Больший запас памяти B300 становится полезен, когда именно емкость HBM ограничивает размещение модели и рабочих данных. Если нагрузка уже помещается в память B200 с необходимым запасом, увеличение емкости само по себе не даст такого же прироста скорости.
Длинный контекст и одновременные запросы
При формировании ответа большая языковая модель сохраняет данные о ранее обработанной последовательности в буфере ключей и значений. Он позволяет повторно использовать уже рассчитанные данные и не выполнять те же вычисления для всей предыдущей части текста при каждом следующем шаге.
Чем длиннее контекст, тем больше памяти занимает такой буфер. Потребность в памяти также растет, когда сервер одновременно обрабатывает несколько запросов.
Поэтому одна и та же модель может создавать разную нагрузку. Работа с короткими запросами нескольких пользователей требует одного объема памяти, обработка длинных документов при большом числе одновременных обращений — другого.
Дополнительная память B300 дает больше пространства для таких данных. Насколько это преимущество будет заметно, зависит от архитектуры модели, длины контекста и числа одновременно выполняемых запросов.
Обучение и дообучение
При обучении память требуется для весов модели, градиентов, состояний алгоритма оптимизации и промежуточных данных, которые нужны для расчета изменений весов.
Если доступной памяти недостаточно, система может распределять данные между несколькими ускорителями или повторно рассчитывать часть промежуточных результатов вместо постоянного хранения. Второй способ снижает расход памяти, но увеличивает объем вычислений.
Больший объем памяти B300 дает больше возможностей для размещения рабочих данных непосредственно на ускорителях. Насколько это сократит время обучения, зависит от структуры модели и способа распределения вычислений.
Когда важна производительность FP4
Одно из заметных различий B300 связано с производительностью вычислений FP4. Но этот показатель важен только для нагрузки, которая действительно использует такой формат.
Меньшая разрядность сокращает объем данных, которые нужно хранить и обрабатывать. Это позволяет выполнять больше операций за тот же промежуток времени. При этом модель и программное обеспечение должны поддерживать такой режим, а снижение точности должно быть допустимо для конкретной задачи.
Поэтому более высокий показатель FP4 у B300 нельзя переносить на любую ИИ-нагрузку. Если задача использует другой формат вычислений или упирается прежде всего в объем памяти, преимущество будет определяться уже другими характеристиками.
В итоге выбор между B200 и B300 нельзя свести к одному числу из спецификации. Для одной нагрузки критичным станет объем памяти, для другой — длина контекста, число одновременных запросов, особенности обучения или используемый формат вычислений. В следующей главе применим эти различия к конкретным задачам и серверным конфигурациям.

B200 и B300 в сервере: конкретные сценарии и конфигурации
Для примеров возьмем Dell PowerEdge XE9780. Сервер поддерживает две интересующие нас конфигурации: восемь NVIDIA HGX B200 по 180 ГБ или восемь NVIDIA HGX B300 по 270 ГБ. В обоих случаях платформа использует два процессора Intel Xeon 6, до 4 ТБ DDR5 и воздушное охлаждение.
Так удобнее сравнивать варианты на реальных задачах: серверная платформа остается одной, меняется вычислительная часть.
Корпоративная система для работы с длинными документами
Задача: компания разворачивает большую языковую модель для поиска и подготовки ответов по внутренним документам. Система работает с объемными договорами, технической документацией или базой знаний и одновременно обслуживает несколько пользователей.
Пример конфигурации:
- Dell PowerEdge XE9780;
- 8 × NVIDIA B300 по 270 ГБ HBM3e;
- 2 × Intel Xeon 6;
- до 4 ТБ DDR5;
- локальные NVMe-накопители под программную среду и рабочие данные.
Восемь ускорителей дают суммарно 2,16 ТБ HBM3e. Память физически распределена между B300, поэтому программная среда должна разделять модель и рабочие данные между ускорителями.
Такой вариант подходит для нагрузки с высокой потребностью в памяти на один ускоритель. Например, когда системе одновременно нужно разместить крупную модель, длинный контекст и данные нескольких активных запросов.
Обучение или дообучение модели
Задача: команда обучает собственную модель или дообучает готовую на корпоративных данных.
Пример конфигурации:
- Dell PowerEdge XE9780;
- 8 × NVIDIA B200 по 180 ГБ HBM3e;
- 2 × Intel Xeon 6;
- до 4 ТБ DDR5;
- NVMe-накопители под наборы данных и рабочие файлы.
Суммарный объем HBM3e восьми B200 составляет 1,44 ТБ. При обучении программная среда распределяет между ускорителями модель и данные, необходимые для вычислений.
Такая конфигурация дает полноценный восьмиускорительный узел Blackwell. Перед проектированием нужно рассчитать объем памяти для выбранной модели и способа обучения: именно этот расчет определяет, сколько данных можно разместить на ускорителях и как придется распределить вычисления.
Высокая нагрузка на готовую модель с FP4
Задача: сервер обслуживает большой поток запросов к готовой модели, которая поддерживает вычисления FP4.
Пример конфигурации:
- Dell PowerEdge XE9780;
- 8 × NVIDIA B300 по 270 ГБ HBM3e;
- 2 × Intel Xeon 6;
- до 4 ТБ DDR5.
Для такой нагрузки важна вычислительная производительность B300 в FP4, которую мы разобрали выше. Практический результат будет зависеть от самой модели и программной среды: поддержка FP4 должна использоваться в реальной работе, иначе паспортный показатель не определит скорость обработки запросов.
Такую конфигурацию можно рассматривать для систем, которым нужно обслуживать большое число обращений к одной или нескольким моделям в пределах одного восьмиускорительного узла.
Несколько серверов для крупной вычислительной задачи
Задача: одной системы с восемью ускорителями недостаточно, поэтому вычисления распределяют между несколькими серверными узлами.
В такой архитектуре можно использовать несколько PowerEdge XE9780 с B200 или B300. Каждый сервер остается отдельным восьмиускорительным узлом, а программная среда распределяет работу уже между несколькими системами.
На этом уровне приходится учитывать не только ускорители. Возрастает значение обмена данными между серверами, объема оперативной памяти и системы хранения. Поэтому число узлов рассчитывают по конкретной модели, объему данных и схеме распределения вычислений.

В каких случаях B300 не дает практического преимущества
B300 дает больше памяти на ускоритель и более высокую производительность в отдельных режимах вычислений. Эти возможности имеют смысл, если задача действительно упирается в соответствующий ресурс. В остальных случаях переход на B300 может не изменить работу системы настолько, чтобы его определяли именно технические требования.
Доступной памяти B200 уже хватает
Если модель, контекст и рабочие данные помещаются в память B200 с необходимым запасом, дополнительная емкость B300 остается свободным ресурсом.
Это не означает, что системы будут работать одинаково во всех режимах. Но сам по себе больший объем HBM3e не ускоряет задачу, которая уже укладывается в доступную память.
Поэтому объем модели нельзя использовать как единственный довод в пользу B300. Сначала нужно понять, сколько памяти фактически занимает нагрузка при рабочих настройках.
Задача не использует режимы, где B300 быстрее
Самое заметное различие вычислительных показателей B200 и B300 связано с FP4 без структурной разреженности. В других форматах разница может быть меньше, а часть заявленных показателей у двух поколений совпадает.
Если рабочая модель использует режим, в котором B300 не получает соответствующего преимущества, ориентироваться на максимальную цифру FP4 из спецификации нет смысла.
Поэтому при сравнении важно знать, в каком формате реально выполняются вычисления. Это точнее показывает возможную разницу между ускорителями, чем общий показатель пиковой производительности.
Ограничение находится за пределами ускорителя
Производительность ИИ-системы зависит от того, насколько быстро ускорители получают данные и обмениваются ими. Если задержка возникает в системе хранения, сети между серверными узлами или другой части инфраструктуры, замена B200 на B300 сама по себе эту проблему не устранит.
В такой ситуации более производительный ускоритель может часть времени ждать данные. Сначала имеет смысл определить, какой компонент ограничивает работу системы, и уже после этого оценивать пользу от перехода на B300.
Дополнительная память не меняет схему размещения модели
Больший объем памяти особенно ценен тогда, когда он позволяет разместить нагрузку иначе: сократить дробление модели между ускорителями или оставить больше рабочих данных непосредственно в HBM.
Но такое преимущество возникает не всегда. Если модель и при B200 уже распределяется между ускорителями удобным для задачи способом, дополнительная память B300 может не менять саму схему вычислений.
Поэтому сравнивать 180 и 270 ГБ только как две цифры недостаточно. Важнее понять, позволяет ли больший объем памяти B300 по-другому разместить конкретную модель и ее рабочие данные.
В итоге B300 имеет техническое преимущество там, где проект использует его дополнительную память или более высокие показатели в нужном режиме вычислений. Если B200 уже закрывает требования по памяти, а ограничение находится в другом компоненте системы, оснований для перехода на B300 становится меньше.
Вопросы и ответы
B300 относится к Blackwell Ultra, получил больше памяти и более высокую производительность в FP4 без структурной разреженности. При этом часть характеристик B200 и B300 совпадает.
Объем зависит от конкретного исполнения и серверной системы. Поэтому при подборе нужно смотреть спецификацию конкретной платформы.
Нет. Разница зависит от режима вычислений и от того, какой ресурс ограничивает задачу.
Не обязательно. Длинный контекст увеличивает расход памяти, поэтому B300 полезен, если возможностей B200 уже недостаточно. Выбор зависит от модели, длины контекста и числа одновременных запросов.
Нет. Способ охлаждения зависит от конструкции сервера. Существуют платформы с B300 как с воздушным, так и с жидкостным охлаждением.
Только если производитель сервера поддерживает обе конфигурации. Нужно проверить питание, охлаждение, системную плату и перечень совместимых компонентов.
Если памяти B200 хватает для выбранного способа обучения, переход на B300 не обязателен. B300 стоит рассматривать, когда дополнительная память или его вычислительные возможности меняют схему работы.
Нет. Общий объем можно учитывать при расчете, но память физически распределена между ускорителями. Программная среда должна отдельно распределять модель и данные между ними.
B300 — отдельный ускоритель Blackwell Ultra. GB300 относится к семейству Grace Blackwell Ultra, где ускорители работают вместе с процессором NVIDIA Grace.



Подробнее...


Подробнее...
Подробнее...

