Supermicro SYS-821GE-TNHR: обзор сервера с 8 NVIDIA H100/H200 для ИИ
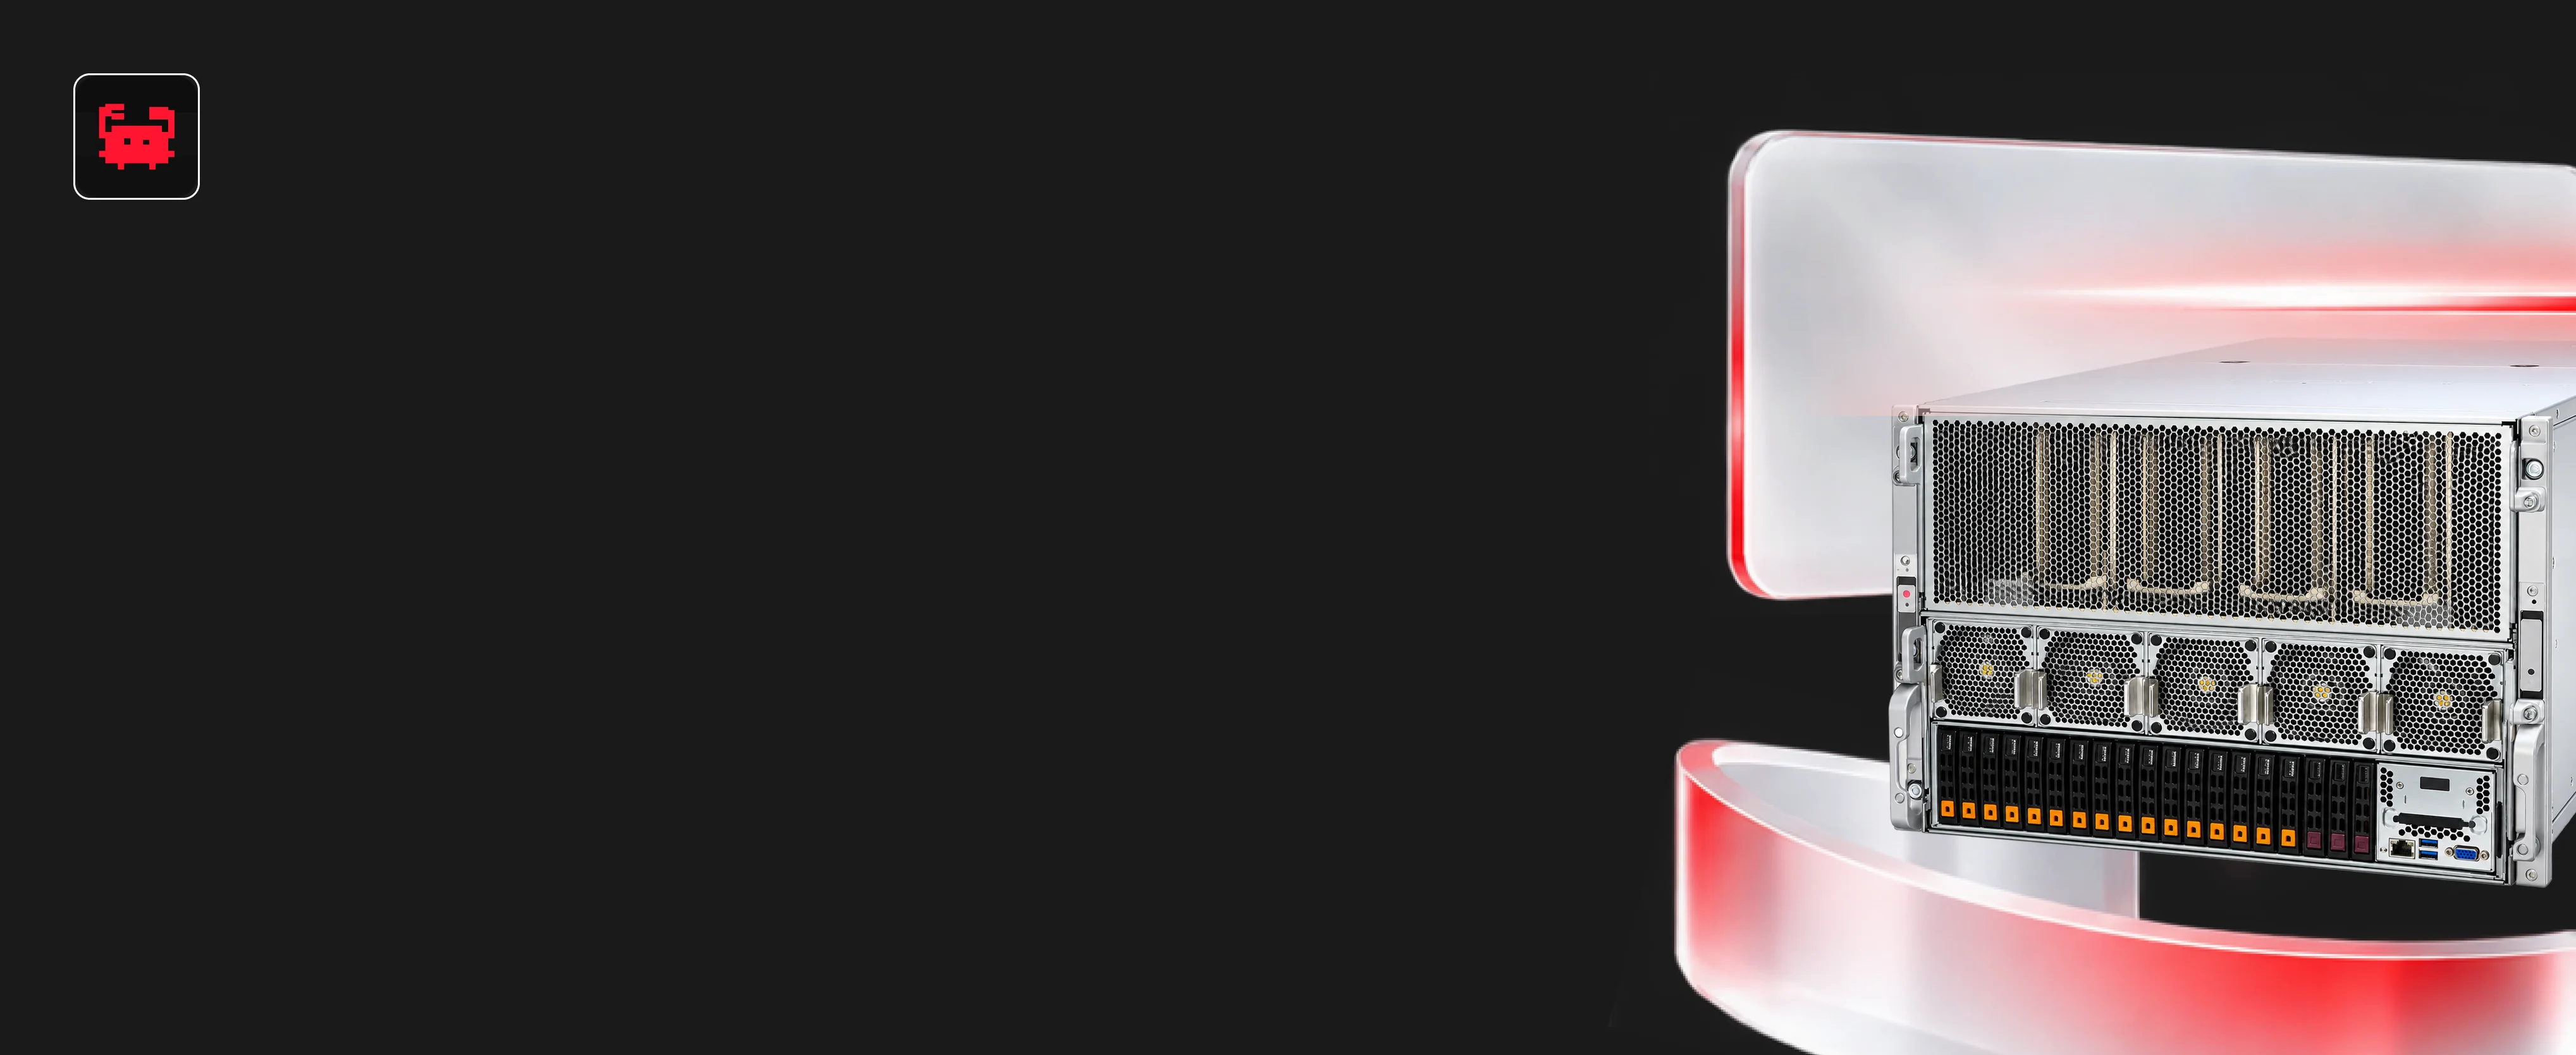
Supermicro SYS-821GE-TNHR рассчитан на проекты, где вычисления нужно распределять между несколькими графическими ускорителями внутри одного узла. Само число ускорителей еще не отвечает на главный вопрос: когда такая платформа действительно нужна и какую конфигурацию выбирать.
В обзоре разберемся, как устроена система на восемь NVIDIA H100/H200, для каких нагрузок ее возможности оправданы и какие параметры нужно учитывать при подборе конфигурации.
- Что представляет собой Supermicro SYS-821GE-TNHR
- Основные характеристики
- Как устроена система из восьми NVIDIA H100/H200
- H100 или H200: чем отличаются варианты сервера
- Для каких задач нужны восемь ускорителей
- Процессоры и оперативная память
- Накопители, PCIe и сеть
- Питание, охлаждение и размещение
- Что определить перед выбором конфигурации
- Вопросы и ответы
Что представляет собой Supermicro SYS-821GE-TNHR
Supermicro SYS-821GE-TNHR — стоечный сервер формата 8U, рассчитанный на установку восьми графических ускорителей в составе NVIDIA HGX H100 или H200. Корпус занимает восемь монтажных единиц в стойке, поэтому модель относится к крупным вычислительным системам с высокой плотностью графических ресурсов.
Платформа поддерживает два процессора Intel Xeon Scalable 4-го или 5-го поколения. В одной системе объединены восемь графических ускорителей, процессорная часть, оперативная память, локальные накопители и слоты расширения.
Supermicro относит SYS-821GE-TNHR к системам для обучения моделей искусственного интеллекта и высокопроизводительных вычислений. Это задает основное назначение сервера: работа с вычислительными нагрузками, которым требуется несколько графических ускорителей в одном узле.
Основные характеристики
Ниже собраны основные параметры Supermicro SYS-821GE-TNHR. Часть возможностей зависит от выбранной комплектации.
| Характеристика | Параметры |
| Форм-фактор | 8U, установка в стойку |
| Процессоры | 2 × Intel Xeon Scalable 4-го или 5-го поколения |
| Число ядер | До 64 ядер и 128 потоков на процессор |
| Графические ускорители | 8 × NVIDIA H100 80 ГБ или 8 × NVIDIA H200 141 ГБ в составе NVIDIA HGX |
| Оперативная память | 32 слота DIMM; до 4 ТБ DDR5-5600 при одном модуле на канал или до 8 ТБ DDR5-4400 при двух модулях на канал |
| Накопители | По умолчанию 12 × 2,5" NVMe и 3 × 2,5" SATA с горячей заменой; еще 4 отсека NVMe доступны как дополнительный вариант |
| Загрузочные накопители | 2 × M.2 NVMe |
| Слоты расширения | 8 × PCIe 5.0 x16 низкопрофильных и 2 × PCIe 5.0 x16 полноразмерных половинной длины в стандартном варианте |
| Сетевые интерфейсы | Дополнительно 2 × SFP+ 10 Гбит/с или 2 × SFP28 25 Гбит/с |
| Охлаждение | До 10 вентиляторов с автоматической регулировкой скорости |
| Блоки питания | 6 × 3000 Вт с резервированием 4+2; дополнительно 8 × 3000 Вт с резервированием 4+4 |
| Размеры, Ш × В × Г | 437 × 355,6 × 843,28 мм |
| Масса | 75,3 кг |
Для четырех дополнительных отсеков NVMe могут потребоваться дополнительные контроллеры или кабели. Остальные параметры зависят от выбранного исполнения системы.

Как устроена система из восьми NVIDIA H100/H200
Вычислительная часть сервера построена на NVIDIA HGX. Эта платформа объединяет восемь графических ускорителей и систему связи между ними. Процессорная часть обменивается данными с ускорителями через PCIe 5.0 x16, а для передачи данных между самими GPU используются NVLink и NVSwitch.
Что представляет собой NVIDIA HGX
NVIDIA HGX задает общую архитектуру для восьми ускорителей внутри одного сервера. Такая компоновка позволяет распределять вычисления между несколькими GPU и передавать данные между ними через отдельные высокоскоростные соединения.
В SYS-821GE-TNHR используются варианты HGX с H100 или H200. В обеих версиях связь между восемью ускорителями построена на NVLink и NVSwitch.
Зачем нужны NVLink и NVSwitch
NVLink обеспечивает высокоскоростную передачу данных между графическими ускорителями. Для платформ HGX H100 и H200 NVIDIA указывает пропускную способность связи между GPU до 900 ГБ/с.
NVSwitch объединяет восемь ускорителей через NVLink в общую систему межсоединений. Совокупная пропускная способность NVLink в восьмиускорительных HGX H100 и H200 достигает 7,2 ТБ/с.
Такая архитектура важна для вычислений, которые распределяются между несколькими GPU. Части одной задачи могут выполняться на разных ускорителях, а промежуточные данные передаются между ними во время работы.
H100 или H200: чем отличаются варианты сервера
Для SYS-821GE-TNHR доступны две версии NVIDIA HGX: с восемью H100 или восемью H200. Оба ускорителя построены на архитектуре NVIDIA Hopper и устанавливаются в формате SXM. Такой формат рассчитан на размещение ускорителей на плате HGX и использование NVLink между ними. Главное различие двух вариантов связано с памятью.
| Параметр | NVIDIA H100 SXM | NVIDIA H200 SXM |
| Архитектура | Hopper | Hopper |
| Память одного ускорителя | 80 ГБ HBM3 | 141 ГБ HBM3e |
| Память восьми ускорителей | 640 ГБ | 1128 ГБ |
| Пропускная способность памяти одного ускорителя | 3,35 ТБ/с | 4,8 ТБ/с |
| Совокупная пропускная способность памяти восьми ускорителей | 26,8 ТБ/с | 38,4 ТБ/с |
| NVLink на один ускоритель | до 900 ГБ/с | до 900 ГБ/с |
| Максимальная расчетная тепловая мощность | до 700 Вт | до 700 Вт |
Показатели для одного ускорителя и восьмиускорительного узла приведены NVIDIA в документации HGX.
Главное различие H100 и H200 — память
H100 оснащен 80 ГБ HBM3, H200 получил 141 ГБ HBM3e. HBM — память с высокой пропускной способностью, которую использует непосредственно графический ускоритель.
У H200 вырос и объем, и скорость работы памяти. NVIDIA указывает пропускную способность 4,8 ТБ/с для H200 против 3,35 ТБ/с для H100.
Поэтому H200 дает больше пространства для данных, которые должны находиться в памяти графического ускорителя во время вычислений. Это особенно важно для крупных моделей и других задач с высокими требованиями к памяти.
Что меняется на уровне восьми ускорителей
В системе с восемью H100 суммарно установлено 640 ГБ памяти ускорителей. Для восьми H200 NVIDIA указывает 1128 ГБ. При этом память физически распределена между отдельными GPU: каждый H100 располагает собственными 80 ГБ, каждый H200 — собственными 141 ГБ.
Поэтому 640 ГБ или 1128 ГБ нельзя воспринимать как память одного ускорителя. Программная среда должна уметь распределять модель и вычисления между несколькими GPU, чтобы использовать ресурсы всего узла.
Что дает более высокая пропускная способность памяти
Объем памяти определяет, сколько данных ускоритель может разместить у себя. Пропускная способность показывает, с какой скоростью данные передаются между памятью и вычислительными блоками.
У H200 показатель выше примерно на 43%: 4,8 ТБ/с против 3,35 ТБ/с у H100. Для всего восьмиускорительного узла NVIDIA приводит 38,4 и 26,8 ТБ/с соответственно.
При выборе между H100 и H200 поэтому важно определить объем памяти, который требуется задаче на каждом ускорителе, и понять, насколько вычисления зависят от скорости работы с данными.
Для каких задач нужны восемь ускорителей
Восемь H100 или H200 нужны для нагрузок, которые способны распределять вычисления между несколькими GPU или требуют ресурсов нескольких ускорителей одновременно. NVIDIA рассматривает восьмиускорительные системы HGX как основу для обучения и дообучения моделей, работы крупных готовых моделей, высокопроизводительных вычислений и анализа данных с графическим ускорением.
При этом количество ускорителей определяет конкретная задача. Значение имеют размер модели, способ ее запуска, объем данных и возможности программного обеспечения.
Обучение крупных моделей
Во время обучения система обрабатывает данные и корректирует параметры модели. По мере роста модели увеличиваются требования к памяти и объему вычислений. Работу можно распределить между несколькими графическими ускорителями.
Восьмиускорительный узел позволяет разделить вычислительный процесс между несколькими GPU внутри одного сервера. Конкретная схема зависит от программной среды и метода обучения. NVIDIA относит обучение моделей разного размера к основным сценариям HGX H100 и H200. Для более крупных задач несколько серверов можно объединять в единую вычислительную систему.
Дообучение готовых моделей
Дообучение применяют, когда существующую модель адаптируют под новую задачу или собственные данные. Требования к ресурсам зависят от размера исходной модели и способа ее дообучения.
NVIDIA рассматривает обучение и дообучение с учетом размера вычислительной системы. Поэтому сама задача дообучения еще не определяет необходимое число ускорителей. Одному проекту может хватить части ресурсов узла, другому потребуется вся система или несколько серверов.
Для расчета важны размер модели, требования к памяти и способ распределения вычислений между GPU.
Работа готовых моделей
После обучения модель используют для обработки запросов и получения результата. Требования к ресурсам здесь также зависят от ее размера и числа одновременно обрабатываемых запросов.
В эталонной архитектуре HGX NVIDIA разделяет крупные модели, которые могут использовать ресурсы целого узла, и модели среднего размера, которые могут работать на отдельном GPU. Поэтому восемь ускорителей требуются далеко не для каждого проекта с искусственным интеллектом.
Несколько GPU становятся нужны, когда одной модели требуется больше ресурсов или программная архитектура предполагает распределение нагрузки между ускорителями.
Высокопроизводительные вычисления и анализ данных
Возможности SYS-821GE-TNHR выходят за пределы задач искусственного интеллекта. Supermicro указывает среди областей применения высокопроизводительные вычисления, аналитику, медицинские исследования, поиск лекарственных соединений, моделирование климата и погоды, финансовые расчеты и промышленную автоматизацию.
В таких проектах графические ускорители используют для вычислений, которые программное обеспечение способно эффективно распараллелить. NVIDIA также относит высокопроизводительные вычисления и анализ данных с графическим ускорением к целевым нагрузкам HGX.
Когда достаточно меньшего числа ускорителей
Восемь H100 или H200 требуются не каждой нагрузке с графическим ускорением. В части проектов модель и рабочие данные помещаются в память одного или нескольких GPU, а программное обеспечение не требует ресурсов всего узла.
NVIDIA предусматривает системы HGX с четырьмя и восемью ускорителями. В эталонной архитектуре размер системы связывается с масштабом вычислительной задачи.
Поэтому SYS-821GE-TNHR стоит рассматривать для проектов, которым нужен восьмиускорительный узел целиком или которые планируется масштабировать на несколько таких серверов. Для менее ресурсоемких задач может подойти система с меньшим числом графических ускорителей.
Процессоры и оперативная память
Восемь графических ускорителей не заменяют центральные процессоры и системную память. Процессорная часть выполняет общесистемные задачи и работает с DDR5, а графические ускорители используют собственную память для вычислений. Поэтому обе подсистемы рассчитывают отдельно.
Какие процессоры поддерживает сервер
Платформа рассчитана на два процессора Intel Xeon Scalable 4-го или 5-го поколения с разъемом LGA-4677. Supermicro указывает до 64 ядер и 128 потоков, а также до 320 МБ кеш-памяти на один процессор. При воздушном охлаждении поддерживаются процессоры с расчетной тепловой мощностью до 350 Вт.
Конкретная модель Xeon зависит от программного обеспечения и нагрузки, которую выполняет процессорная часть. Здесь важны число ядер, частота и требования программы к центральным процессорам.
Сколько оперативной памяти можно установить
В сервере предусмотрено 32 слота DIMM для DDR5 RDIMM с коррекцией ошибок ECC. Производитель указывает два варианта максимального объема и скорости памяти.
| Заполнение памяти | Максимальный объем | Заявленная скорость |
| По одному модулю на канал | до 4 ТБ | 5600 МТ/с |
| По два модуля на канал | до 8 ТБ | 4400 МТ/с |
МТ/с показывает количество миллионов передач данных в секунду. При выборе памяти поэтому нужно учитывать требуемый объем и скорость, доступную при выбранной схеме заполнения слотов.
Чем системная память отличается от памяти ускорителей
DDR5 и HBM выполняют разные функции. Системная DDR5 относится к процессорной части сервера. С ней работают центральные процессоры и программы, которые выполняются на стороне основной системы.
HBM находится на графических ускорителях и используется непосредственно во время вычислений на GPU. Поэтому объемы DDR5 и HBM нельзя складывать и считать единым ресурсом.
Конфигурация может содержать несколько терабайт системной памяти и одновременно сотни гигабайт памяти графических ускорителей. Каждая подсистема используется для своей части вычислительного процесса.
Накопители, PCIe и сеть
В сервере предусмотрены фронтальные отсеки для локальных накопителей, отдельные M.2 для загрузочных дисков и слоты PCIe для дополнительных устройств. Часть оснащения зависит от выбранного варианта платформы.
Какие накопители можно установить
В базовой конфигурации предусмотрено 15 фронтальных отсеков с горячей заменой:
- 12 × 2,5" NVMe;
- 3 × 2,5" SATA.
Дополнительный вариант увеличивает число NVMe до 16. В таком исполнении сервер получает 19 фронтальных отсеков: 16 NVMe и 3 SATA. Для четырех дополнительных NVMe Supermicro указывает, что могут потребоваться дополнительные контроллеры или кабели.
Отдельно на системной плате расположены два разъема M.2 NVMe. Производитель указывает их для загрузочных накопителей. Это позволяет отделить диски с операционной системой от основной дисковой подсистемы.
Для чего нужны слоты PCIe 5.0
В стандартном варианте доступны восемь низкопрофильных слотов PCIe 5.0 x16 и два полноразмерных слота половинной длины PCIe 5.0 x16. Обозначение x16 означает, что устройству доступны 16 линий PCIe.
Слоты можно использовать для сетевых адаптеров, контроллеров хранения и других совместимых плат расширения. Их количество позволяет подбирать дополнительные интерфейсы под конкретную схему подключения сервера.
Какие сетевые интерфейсы доступны
На текущей странице модели Supermicro указывает два дополнительных варианта сетевых интерфейсов:
- 2 × SFP+ 10 Гбит/с на Intel X710-BM2;
- 2 × SFP28 25 Гбит/с на Broadcom BCM57414.
Фиксированной сетевой конфигурации у платформы нет. Состав адаптеров выбирают с учетом того, как сервер будет подключен к хранилищам, другим вычислительным узлам и существующей сети. Дополнительные сетевые платы при необходимости устанавливают в слоты PCIe.
Для многосерверных систем требования к сети становятся значительно выше. В эталонной архитектуре HGX H100/H200 NVIDIA использует отдельную высокоскоростную сеть для обмена между вычислительными узлами.
Питание, охлаждение и размещение
SYS-821GE-TNHR занимает 8U и весит 75,3 кг без упаковки. Глубина корпуса составляет 843,28 мм. Эти параметры нужно учитывать при выборе стойки и планировании места для установки.
Как устроено питание
В стандартной комплектации сервер оснащается шестью блоками питания по 3000 Вт. Supermicro использует схему резервирования 4+2: четыре блока участвуют в питании системы, еще два создают резерв. Производитель также предлагает вариант с восемью блоками по схеме 4+4.
Номинал 3000 Вт относится к одному блоку питания. Полную мощность блок выдает при входном напряжении 207–240 В переменного тока. При 200–207 В доступная мощность составляет 2880 Вт.
Блоки питания соответствуют уровню эффективности Titanium. Supermicro указывает эффективность 96% и выше для используемых блоков.
Как охлаждается сервер
Основное исполнение SYS-821GE-TNHR использует воздушное охлаждение. В корпусе устанавливается до десяти высокопроизводительных вентиляторов. Сервер контролирует их скорость и температуру компонентов и автоматически регулирует интенсивность охлаждения.
Для модели также существует исполнение SYS-821GE-TNHR-LC0 с жидкостным охлаждением графической подсистемы. В перечне сертифицированных систем Supermicro вариант с H200 также указан с возможностью жидкостного охлаждения.
После выключения система продолжает охлаждение около 120 секунд. В это время Supermicro рекомендует не отключать кабели питания. После завершения процедуры индикатор питания меняет состояние.
Для работающего сервера производитель указывает температуру окружающей среды от 10 до 35 °C и относительную влажность от 8 до 90% без образования конденсата.
Что учитывать при размещении
Корпус занимает восемь монтажных единиц. При глубине 843,28 мм и массе 75,3 кг стойку нужно проверить по внутренней глубине и допустимой нагрузке.
Отдельно нужно предусмотреть питание для выбранной схемы блоков и охлаждение, рассчитанное на фактическую конфигурацию. При размещении нескольких таких серверов параметры электропитания и отвода тепла рассчитывают уже для всей стойки.

Что определить перед выбором конфигурации
Характеристики платформы задают доступные варианты, но конкретный состав сервера зависит от задачи. Перед подбором стоит собрать исходные данные по вычислительной нагрузке, памяти, хранению, сети и условиям размещения.
Какая нагрузка будет работать на сервере
Для начала нужно описать вычислительную задачу. Важно знать:
- какое программное обеспечение будет использовать сервер;
- какая модель или другой вычислительный процесс будет запускаться;
- идет речь об обучении, дообучении, работе готовой модели или другом типе вычислений;
- сколько задач должно выполняться одновременно;
- будет ли сервер работать самостоятельно или вместе с другими вычислительными узлами.
Эти данные помогают определить требуемое число ускорителей и понять, как нагрузка сможет использовать их ресурсы.
Сколько памяти требуется на ускорителях
При выборе между H100 и H200 ключевым параметром становится потребность задачи в памяти GPU. На этапе подбора нужно определить требуемый объем памяти для самой модели и данных, с которыми она работает.
Также важно проверить, умеет ли используемое программное обеспечение распределять вычисления между несколькими ускорителями. От этого зависит возможность использовать ресурсы всего восьмиускорительного узла.
Какие ресурсы нужны процессорной части
Отдельно рассчитывают нагрузку на центральные процессоры и системную память. Исходными данными служат требования программного обеспечения к числу процессорных ядер, частоте и объему оперативной памяти.
DDR5 рассчитывают отдельно от памяти графических ускорителей. Эти ресурсы выполняют разные функции и подбираются по своим требованиям.
Где будут храниться данные
До выбора накопителей нужно определить схему работы с данными:
- какой объем требуется хранить непосредственно на сервере;
- будут ли основные данные находиться на внешней системе хранения;
- сколько места потребуется для операционной системы и прикладных программ;
- какие требования нагрузка предъявляет к чтению и записи данных.
После этого можно определить количество локальных NVMe, необходимость дополнительных отсеков и конфигурацию загрузочных M.2.
Как сервер будет подключен к инфраструктуре
Сетевые требования зависят от роли вычислительного узла. Для одиночного сервера, доступа к внешнему хранилищу и совместной работы нескольких серверов требования различаются.
Перед подбором сетевых адаптеров нужно знать необходимую скорость передачи данных, существующую сетевую инфраструктуру и схему взаимодействия с другими узлами.
Для многосерверной системы отдельного внимания требует сеть между вычислительными узлами. В эталонной архитектуре HGX H100/H200 NVIDIA использует отдельную сеть с высокой пропускной способностью и низкой задержкой для обмена между серверами. Поэтому дополнительные интерфейсы 10 и 25 Гбит/с, которые Supermicro предлагает для модели, нельзя считать универсальным вариантом для любой многосерверной системы.
Подходит ли площадка для установки
Перед поставкой нужно проверить стойку, электропитание и охлаждение. Здесь нужны параметры самой площадки:
- сколько свободного места есть в стойке;
- подходит ли стойка по глубине и допустимой нагрузке;
- какое питание доступно;
- какую тепловую нагрузку способна отводить система охлаждения;
- сколько подобных узлов планируется установить рядом.
Числовые требования самого сервера уже известны, поэтому на этом этапе их сопоставляют с возможностями площадки.
Совместимо ли программное обеспечение
До утверждения спецификации нужно проверить операционную систему, используемые приложения и их требования к аппаратной платформе.
На текущей странице модели Supermicro перечисляет ESXi 8.0, Hypervisor 8.2.1, RHEL 8.7, RHEL 9.2 и SLES 15 SP4. Производитель также ведет отдельную матрицу совместимости и сертификации операционных систем, которую стоит проверять для конкретной программной среды.
Вопросы и ответы
В официальной спецификации модели заявлены NVIDIA HGX H100 8-GPU и HGX H200 8-GPU. B100 и B200 для SYS-821GE-TNHR производитель не указывает. Для HGX B200 у Supermicro есть другие серверные системы, включая SYS-A21GE-NBRT и SYS-A22GA-NBRT.
Supermicro описывает два отдельных варианта: восемь H100 либо восемь H200. Смешанная конфигурация из H100 и H200 в опубликованной спецификации SYS-821GE-TNHR не заявлена.
SYS-821GE-TNHR заявлен как система HGX на восемь H100 или восемь H200. Вариант этой модели с меньшим числом ускорителей в спецификации не указан. При этом сама архитектура NVIDIA HGX существует и в четырехускорительных системах других моделей.
Да. Supermicro публикует сведения об исполнении SYS-821GE-TNHR-LC0 с жидкостным охлаждением графической подсистемы. Для SYS-821GE-TNHR с H200 жидкостное охлаждение также указано в перечне сертифицированных систем производителя.
На текущей странице модели Supermicro перечисляет ESXi 8.0, Hypervisor 8.2.1, RHEL 8.7, RHEL 9.2 и SLES 15 SP4. Полный актуальный перечень нужно проверять в матрице совместимости и сертификации производителя.
Да. NVIDIA рассматривает восьмиускорительные HGX H100/H200 как вычислительные узлы, которые можно объединять в более крупные системы. В эталонной архитектуре NVIDIA такие узлы соединяются отдельной высокоскоростной сетью для обмена данными между серверами.



Dell PowerEdge R760 — двухпроцессорный стоечный сервер высотой 2U, рабочая лошадка линейки PowerEdge

Подробнее...




Подробнее...

